词库里有什么
你猜了六节课的词,从没把这 5 万个词当成整体看过。今天拿一个你关心的社会议题当筛子,看它知道什么、不知道什么、偏向哪边。
这 5 万个词不是词典,是一份词频快照
| 词频名次 = 下标 + 1 | 那附近的词(按词表下标顺序读出) |
|---|---|
| 1–10 | 是 在 和 我 有 就 你 他 都 我们 |
| 1,001–1,010 | 中间 脸 仍 那你 一条 正式 长期 车辆 恢复 使得 |
| 10,001–10,010 | 浴室 气得 七天 光彩 收视率 原名 欢呼 洋葱 王思聪 攻势 |
| 30,001–30,010 | 成群结队 大早 荣登 贪吃 太阳光 内网 平底 可向 不惯 救救 |
| 49,991–50,000 | 十只 嫁过来 大海捞针 改朝换代 逢场作戏 贪图便宜 意外事件 夺权 那阵 拔火罐 |
前面是虚词,中间是生活,末尾是成语和冷门词 —— 这就是「常用」的真实样子。
手机输入法的联想词库:你常打什么,它就记什么,从不问对不对。词频快照也一样 —— 它记的不是「哪些词是对的」,是「那时候的人常写什么」。
你的 data/vocab.json 是它的前 50,000 个 1–4 字词。单字只收 HSK(汉语水平考试)名单里的字;课堂净化挡掉 160 个不适合上课的词,由后面的词补上。
有的词它没见过:不是不重要,是那时候还没人这么说
这几个词在原始的 143,613 个词里也没有,不只是没挤进前 5 万。
语料有截止日期,词向量只知道那之前的世界。你猜「新冠」,得到的永远是「词表里没有这个词」。
类比:一个断网好几年的朋友。聊什么都行,就是别问他这几年才出现的新词 —— 他不是不关心,是真没听说过。
种子词的向量平均一下,离它最近的词就是议题的地盘
挑一个你真关心的:环境、就业、留学……第 7 页有菜单。
环境 污染 环保 气候 垃圾。都得在词表里,游戏里猜一下就知道。
5 个 200 维向量加起来除以 5,再把长度归一 —— 只要方向。
拿它和 5 万个词逐个算余弦,乘 100,和游戏分数一个口径。
从高到低排,前 200 就是这个议题在词库里的地盘。
| # | 词 | 相似度 | # | 词 | 相似度 |
|---|---|---|---|---|---|
| 1 | 环境污染 | 75.66 | 5 | 自然环境 | 72.32 |
| 2 | 污染物 | 72.72 | 6 | 生活环境 | 71.06 |
| 3 | 生态环境 | 72.47 | 7 | 废弃物 | 70.57 |
| 4 | 空气污染 | 72.39 | 8 | 空气 | 69.64 |
完整 200 行:reference-impl/docs/topics/环境.md
游戏里的「提示」做的就是这件事(engine.nearest:找目标词的最近邻),只是种子只有一个词。课堂净化挡掉 160 个词,是老师筛「不要什么」;今天你筛「要什么」—— 同一个词库,两种筛法。
五个人的口味平均一下,再给整个食堂的菜排序 —— 排最前的,就是这五个人共同爱吃的。
同一个议题,词库有自己的说法:这里的「环境」首先是「污染」
| 前 200 里含「污 / 废 / 排 / 脏」 | 含「气候 / 碳」 | 气候类的词排第几 | 干脆不在词表 |
|---|---|---|---|
| 23 个 | 3 个 | 二氧化碳 第 49 · 气候变化 第 53 · 低碳 第 126 | 全球变暖 · 碳中和 · 垃圾分类 |
环境污染 75.66 · 空气质量 69.22
生态环境 72.47
看到就点头的词。它们是议题的骨架,也是你挑主题目标词的候选。
治理 65.40 · 卫生 65.36
微生物 65.11 · 脏乱差 61.01
你事先想不到,但它们排得很靠前:这份语料里「环境」常和「整治 / 卫生」连着说。
这些 60.57 · 其次 57.87
再者 57.32 · 所以 55.57
高频虚词跟谁都沾边,任何议题都会混进来。词向量的通病,标掉就好。
再加负种子筛一次。负种子是你想让结果离开的方向,这里用污染 污水 垃圾,从中心里减掉一半。气候变化升到第 12,前 5 换成右边这些 —— 筛子换一下,地盘就换一块。
语料里的偏见会原样存进向量:
这条轴上,护士在一头,程序员在另一头
轴 = 「女性」的向量 − 「男性」的向量,归一化后只留方向。探针词 = 你拿来测「偏哪一头」的词,这里全用职业名。
投影 = 探针词和这条轴的点积 × 100:正数偏「女性」,负数偏「男性」,0 附近两边都不沾。
参考版:npm run topic -- --axis 女性,男性 --probe …
国王 − 男人 + 女人 ≈ 王后 70.50
爸爸 − 男人 + 女人 ≈ 妈妈 91.71
北京 − 中国 + 日本 ≈ 东京 69.36
这不是词典的真理,是这份语料的统计。它会进你的游戏 —— 提示功能递给你的邻居,就是从这里来的。
挑一个你真的关心的议题,种子词已经替你验过在词表里
| 议题 | 种子词(都在词表里) | 筛出来是什么样 |
|---|---|---|
| 环境 | 环境 污染 环保 气候 垃圾 | 「环境」首先是「污染」,气候变化排第 53 |
| 性别 | 女性 男性 性别 平等 歧视 | 前 5:性别歧视、男女、同性恋、男女平等、同性 |
| 老龄化 | 老人 养老 老龄化 退休 养老院 | 退休金、赡养、敬老院、孤寡老人、护工 —— 养老在这里是家里的事和钱的事 |
| 教育 | 高考 学校 考试 补习 升学 | 中考 87.31 第一,前 30 里 13 个带「考」 |
| 留学 | 留学 移民 签证 海外 出国 | 出国留学、留学生、绿卡、回国、海归,第 17 名是「米国」 |
| 就业 | 就业 失业 工作 裁员 加班 | 下岗 73.90 第一,排在找工作 72.11、辞职 71.84 前面 |
| 心理健康 | 抑郁 焦虑 心理 压力 睡眠 | 情绪、精神压力、焦虑症、恐惧、失眠 |
种子词先在游戏里各猜一次。看到「词表里没有这个词」就换近义词,对人不计次,随便试。
就用表里这五个种子词。筛出来的表里可能混进擦边词,标成噪音即可。
让 agent 给你写一个筛子,
然后读它筛出来的表
- 选议题、写 5 个种子词,在游戏里各猜一次,确认都在词表里。
- 把右边这段 briefing 发给 agent,尖括号里换成你的议题和种子词。
- 跑起来,打开 docs/topic-<议题>.md,先读前 60 行。
- 逐行打标记:意料之中 / 意外 / 噪音,数一数三种各有几个。
- 加 2–3 个负种子再跑一次,另存一份,和原表比前 10 换了几个。
- 在文件末尾写三句话:知道什么 / 不知道什么 / 偏向哪边。
一张 200 行的表:前几名是带议题字眼的复合词(「环境」→ 环境污染 75.66),往下开始出现意外的词,再往下混进「这些」「所以」这类虚词。
种子词全被跳过 → 换常见的近义词。分数全是零点几 → 忘了乘 100。前几名是种子词本身 → 没排除种子词。用第 4 页的种子跑,顺序对、分数整体偏低 → 平均完没归一化。卡死了对照老师参考版 scripts/topic-filter.mjs,别直接抄。
<goal>
写一个脚本 scripts/topic.mjs:读 data/vocab.json 和
data/vectors.f32(每词 200 个 float32,已归一化),
把 --seeds 里几个种子词的向量平均并归一化,算它和
词表里每个词的余弦 × 100,取前 200,按分数从高到低
写成 Markdown 表到 docs/topic-<议题>.md。
列:序号、词、分数、词频名次(词在 vocab.json 里的
下标 + 1)、标记(留空)。
</goal>

<constraints>
- 支持 --minus 词,词:减去负种子平均向量的一半再归一化
- 带 --minus 时另存成
  docs/topic-<议题>-减<负种子>.md,不覆盖原表
- 种子词不在词表里要打印警告并跳过,一个都不在就报错退出
- 种子词本身不出现在结果里
- 不引入任何数值计算库,只用 for 循环
- 跑完把命令和前 10 行原样贴给我看
</constraints>

<fallback>
拿不准 vectors.f32 的格式,先去读 server/ 里
加载它的那段代码,不要猜。
</fallback>
筛出来的 200 个词想画到纸上?先找那个最能拉开它们的方向
参考实现在 server/pca.mjs 里只用 for 循环自己算,不引入任何数值库。
这张图能看出「越猜越近」,但看不出「谁分数高」
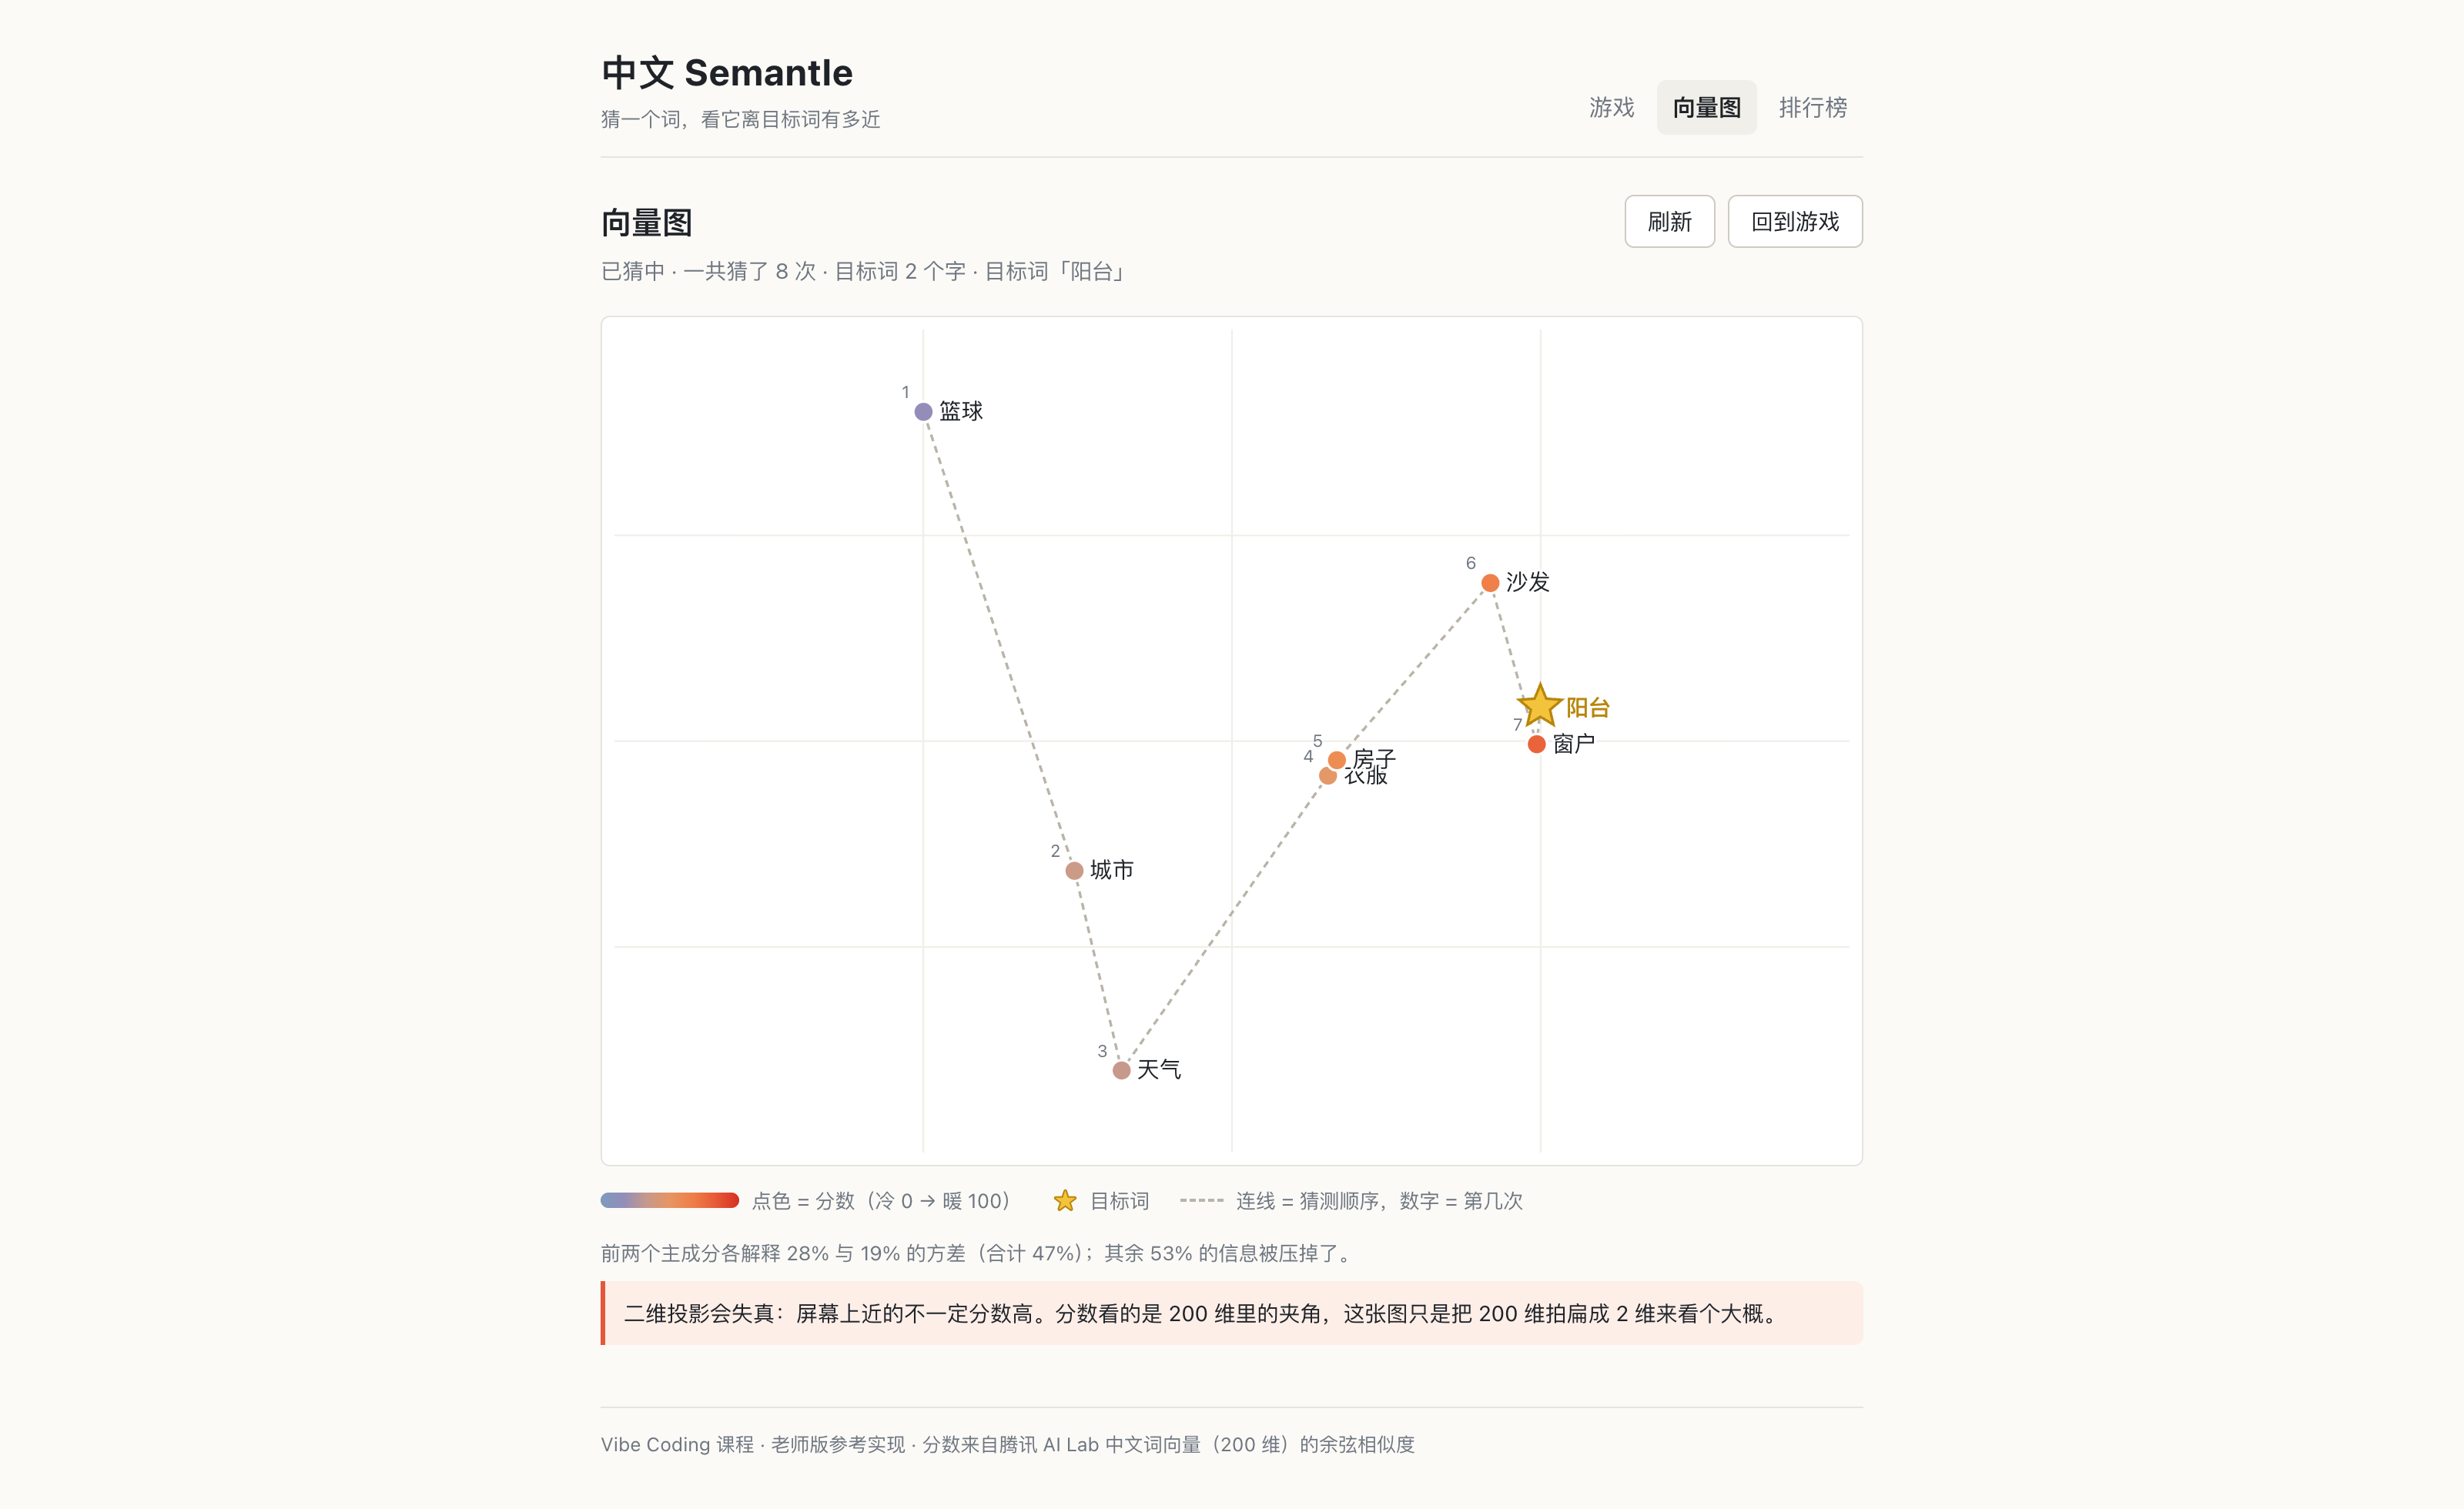
目标词「阳台」,按 篮球 → 城市 → 天气 → 衣服 → 房子 → 沙发 → 窗户 → 阳台 的顺序猜完。点色 = 分数(冷 0 → 暖 100),星形 = 目标词。
前两个主成分各解释 28% 与 19% 的方差,合计 47%,离 100% 还差一半多 —— 差的那部分信息压扁时被扔掉了。两个数之和离 100% 越远,图越不可信。
屏幕上挨在一起的两个点,分数可以差很多:「衣服」46.93(第 457 名)和「房子」57.69(第 109 名)几乎叠在一张图上,200 维里它们差着 348 个名次。
两件事:整理主题目标词,写好 Demo Day 那一页
- 把 docs/topic-<议题>.md 的标记补完,写完末尾那三句话:知道什么 / 不知道什么 / 偏向哪边。
- 从前 200 里挑 20 个具体名词,存成 data/targets-<议题>.json(格式和 data/targets.json 一样);让 agent 证明这 20 个都在 vocab.json 里。
- Demo Day 准备:名次差是第 6 节作业算过的;没算的下一节之前按 docs/benchmark-sheet.md 的三步算出来。
- 写 docs/hire.md,300–500 字:结论一句话 → 证据 → 对照 → 局限 → 变条件。大声念一遍并计时,1 分钟内念完。
- 列 10 分钟提纲,四段:做了什么 → 怎么验证的 → 数据说明什么 → 局限在哪。第一段开着游戏演示 3 分钟;后三段共 4 分钟,念 hire.md 占其中 1 分钟;最后 3 分钟老师提问,不算在四段里。
- 加分(二选一):让 agent 把这一局的 PCA 散点图加进游戏(briefing 在作业单里);或给游戏加一个「主题局」开关,用你那 20 个词当目标词。
docs/topic-<议题>.md、data/targets-<议题>.json(附证明都在词表里的那条命令输出)、docs/hire.md、10 分钟提纲。加分:散点图截图 1 张,或主题局那一局的证明(放弃后揭晓的目标词 + 那 20 个词并排)。
自检三条:20 个目标词全是具体名词且都在词表里;hire.md 至少 3 个自己的数字 + 那个模型的名次差;1 分钟内念得完。
约 45 分钟:词库 15 + 准备 30
最后一节:先看两张榜,
再听你讲 10 分钟。
带三样东西来:能在你电脑上跑起来的游戏、A 和 B 两张排行榜(12 个结果文件,36 局)、那一页念得完的 hire.md。