Agent
上节课来回传话的那个人是你。今天把「你」换成一段程序 —— 它自己看分数、自己想、自己猜,跑完一整局。这就是 agent(智能体)。
上节课那个循环是你在跑:看分数 → 想 → 猜 → 再看分数
你在网页上读到「医院 61.3,第 318 名」,把这一行抄进记录表,再抄回给模型看。
模型(或者你自己)把整张历史表看一遍,排除一个方向,锁定另一个方向。
你把它给的那个词敲进输入框,回车。这一下按钮是你按的 —— 模型按不了。
新分数出来了,回到第 1 步。你一晚上重复了几十遍,中间还抄错过。
agent 里没有新东西:模型 + 循环 + 工具,缺一样它就动不了
只会一件事:给它一段文字,它接着往下写。它不会上网、不会算分、不会点按钮,也记不住上一轮 —— 每轮都要把历史重新讲给它听。
像一个关在玻璃房里的天才:只能写纸条递出来,什么也够不着。
一段重复执行的程序,直到满足停止条件。我们的停止条件写死两条:猜中,或者用满 50 次。
像跑步机上的圈数:每一圈动作完全一样,变的只有计数器和你的体力。
模型影响外界的唯一方式:它写下一个词,程序拿这个词去调游戏,再把分数抄回给它。游戏就是它的工具。
像隔着玻璃递纸条:你写「按红色那个」,外面的人替你按,再把结果递回来。
上节课你就是那圈「循环 + 工具」,只不过是用手做的。模型一个参数都没变,变的是外面那圈程序 —— 所以 agent 不是一种更聪明的模型,是一种更勤快的接线方式。把这三样接起来转的这一整圈,有个专名:agent loop(智能体循环),作业单上就是这么写的。
模型按不了按钮,所以你得规定它把词写成程序能读的一行
## 输出格式

每轮只输出一行 JSON,不要任何解释、思考过程或多余文字:

{"guess":"词"}

## 退路条款

不确定时也必须给出一个词。一个字数对得上的常见中文名词
永远是合法输出——宁可猜错,也不要不猜、不要输出空内容、
不要用解释代替猜测。
程序读不懂「我觉得可以试试苹果吧」。JSON(一种给程序读的文本格式,花括号加冒号)里 guess 后面那个词,程序一行代码就取出来了。
拿到词之后程序去调 game.guess(词) —— 和你在网页上按回车调的是同一段代码。模型碰不到它,程序替它调,再把分数和名次写回下一轮的历史里。
参考实现的 bench/agent.mjs 会退而求其次:找引号里的 1–4 字词、找冒号后的词。连续两次都解析不出来,才按「词表外」计一次。
规则不对称:人类猜到词表外的词不计次,AI 猜到词表外的词要计一次。它没法一直乱试。但「目标词几个字」两边都知道:人看状态栏,AI 看每轮 user 消息。
猜词 prompt 至少四样:规则、分数含义、输出格式、退路
「跟我玩这个游戏,我会告诉你分数,你来猜词。」
它不知道分数是 -100 到 100 还是 0 到 1,不知道 40 分算近还是算远,不知道要输出什么格式,也不知道拿不准的时候该干什么。这四件事你没说,它就自己编一个。
结果:第一轮它回你一段「让我们先分析一下这个游戏的策略……」,程序一个词都解析不出来,白白计掉一次。
规则:目标词是固定字数的,每轮 user 消息会告诉它是几个字,只猜这个字数的词;封闭词表,最多 50 次,词表外的词白白浪费一次机会。
分数含义:分数 = 语义相似度 × 100,比的是意思和用法,不是字形和拼音;名次 = 在目标词最近 3000 个词里排第几,有名次不等于很近(前 10 名贴脸,前 100 名很近,两三千名只是沾到边)。
输出格式:只输出一行 JSON,不要解释。
退路:不确定也必须给出一个词,宁可猜错也不要不猜。
结果:每一轮都能解析出词,你才有数据可看。
注意这里的退路和第 1 节反过来了:写代码时是「拿不准就停下来问我」,猜词时是「拿不准也必须给一个词」。退路条款从来不是「让它闭嘴」,而是提前替它规定拿不准时该做什么 —— 不规定,它就自己决定,而它的决定通常是讲一段道理。这四样参考实现的 prompts/baseline.md 里都有,你的 prompt 只要比它强就算进步。
一把 key 调所有模型 —— 所以这把 key 就是你的钱包
| 模型 | 每猜 $ | 每局上限 $ | 3 局上限 $ |
|---|---|---|---|
| Claude Sonnet 5 | 0.0035 | 0.175 | 0.525 |
| GPT-6 Astra | 0.0175 | 0.875 | 2.625 |
| Gemini 3.1 Pro Preview | 0.0036 | 0.180 | 0.540 |
| DeepSeek V4 Pro 0813 | 0.00185 | 0.092 | 0.277 |
| Qwen3.8 Max (0902) | 0.0033 | 0.165 | 0.495 |
| Qwen3.5-9B(对照组) | 0.00016 | 0.008 | 0.024 |
项目根目录的 .env 文件里一行:OPENROUTER_API_KEY=sk-or-…。它已经被 .gitignore 挡住:不进存档,也不会跟着代码传出去。
换模型只改一个 id:--model qwen/qwen3.5-9b 换成 --model anthropic/claude-sonnet-5。不用注册六家账号、不用六套代码。第 6 节要接满六个,靠的就是这一点。
key 绑的是你充的那 10 美元,谁拿到谁能花。别发给任何人、别贴进和 agent 的对话、别出现在截图里。最常见的泄露方式是一句「我把 .env 发你,帮我看看对不对」。
你的项目现在有三个框,第三个在别人的电脑上
前端
localhost:5173 client/同时跑着的另一个程序
localhost:3001 server/两个程序会互相说话
请求:我猜「苹果」
响应:{ score: 分数, rank: 名次 }
node_modules/ · 零件(npm install 拿回来的)别人电脑上的模型
openrouter.ai请求:历史 + 你的 prompt
响应:下一个词
你的后端给前端开了一扇 API 门:你自己也做了一个 API。
OpenRouter 给你的后端开的门,也叫 API。
key 绑着你充的钱,谁拿到谁能花。
它放在 .env 里,不进存档。
跑不通时先看门口的回话编号,再决定改什么:401 看 key,402 去充值,404 换模型 id,429 等一等。
写自己的 prompt,让 agent 跑完一整局
- 先存档,再动手:对 Claude Code 说「先存档,再动手」,让它先给项目拍一张照片。
- 新建 prompts/mine.md,照第 5 页那四样写,先控制在 15 行以内。文件名去掉 .md 就是它的名字,会写进结果文件。
- 给 Claude Code 一段 briefing(任务交底):「照 reference-impl/bench/ 的方式做一个猜词 agent:读 prompts/mine.md 当 system prompt,循环调 OpenRouter,每轮记下词、分数、名次,猜中或满 50 次停,结果写成 JSON。拿不准的先停下来问我。」
- 先用不联网的假模型跑通循环:npm run bench -- --provider mock --prompt prompts/mine.md --games 1。这一步不需要 key。
- 再换真模型跑一局:npm run bench -- --model qwen/qwen3.5-9b --prompt prompts/mine.md --games 1。对照组小模型最便宜,一局几分钱。
- 跑完打开 results/ 里新出现的那个 JSON,找到 games[0].guesses(总轮数)和 games[0].history(每一轮的词和分数)。跑通就存档,说明写「第一个模型跑通」。
终端一行行往下滚,每行一轮:
[1/5 阳台] 第 1 轮 · 第 1 猜 · 为何 21.82 >3000 · 0ms
最后两行是汇总(猜中几局、中位数几猜、平均花费)和「结果已写入 results/…json」。整屏长什么样,见下一页那张终端图。
先跑第 4 步的 mock。mock 通、真模型不通 = 问题在网络和 key,不在你的循环:401 key 错,402 余额不足,404 模型 id 写错或下架,429 请求太频繁。把报错原文整段贴给 agent,别让它上来就改循环。
真模型比 mock 慢得多:mock 一轮 8 毫秒,会先思考的模型一轮可能几十秒,终端不动不等于卡死。还有,模型自己卡住(反复猜同一个词)也照样写结果文件,那一局按 51 猜计 —— 这是故意的。
一局就长这样:一行一轮,最后一行告诉你花了多少钱
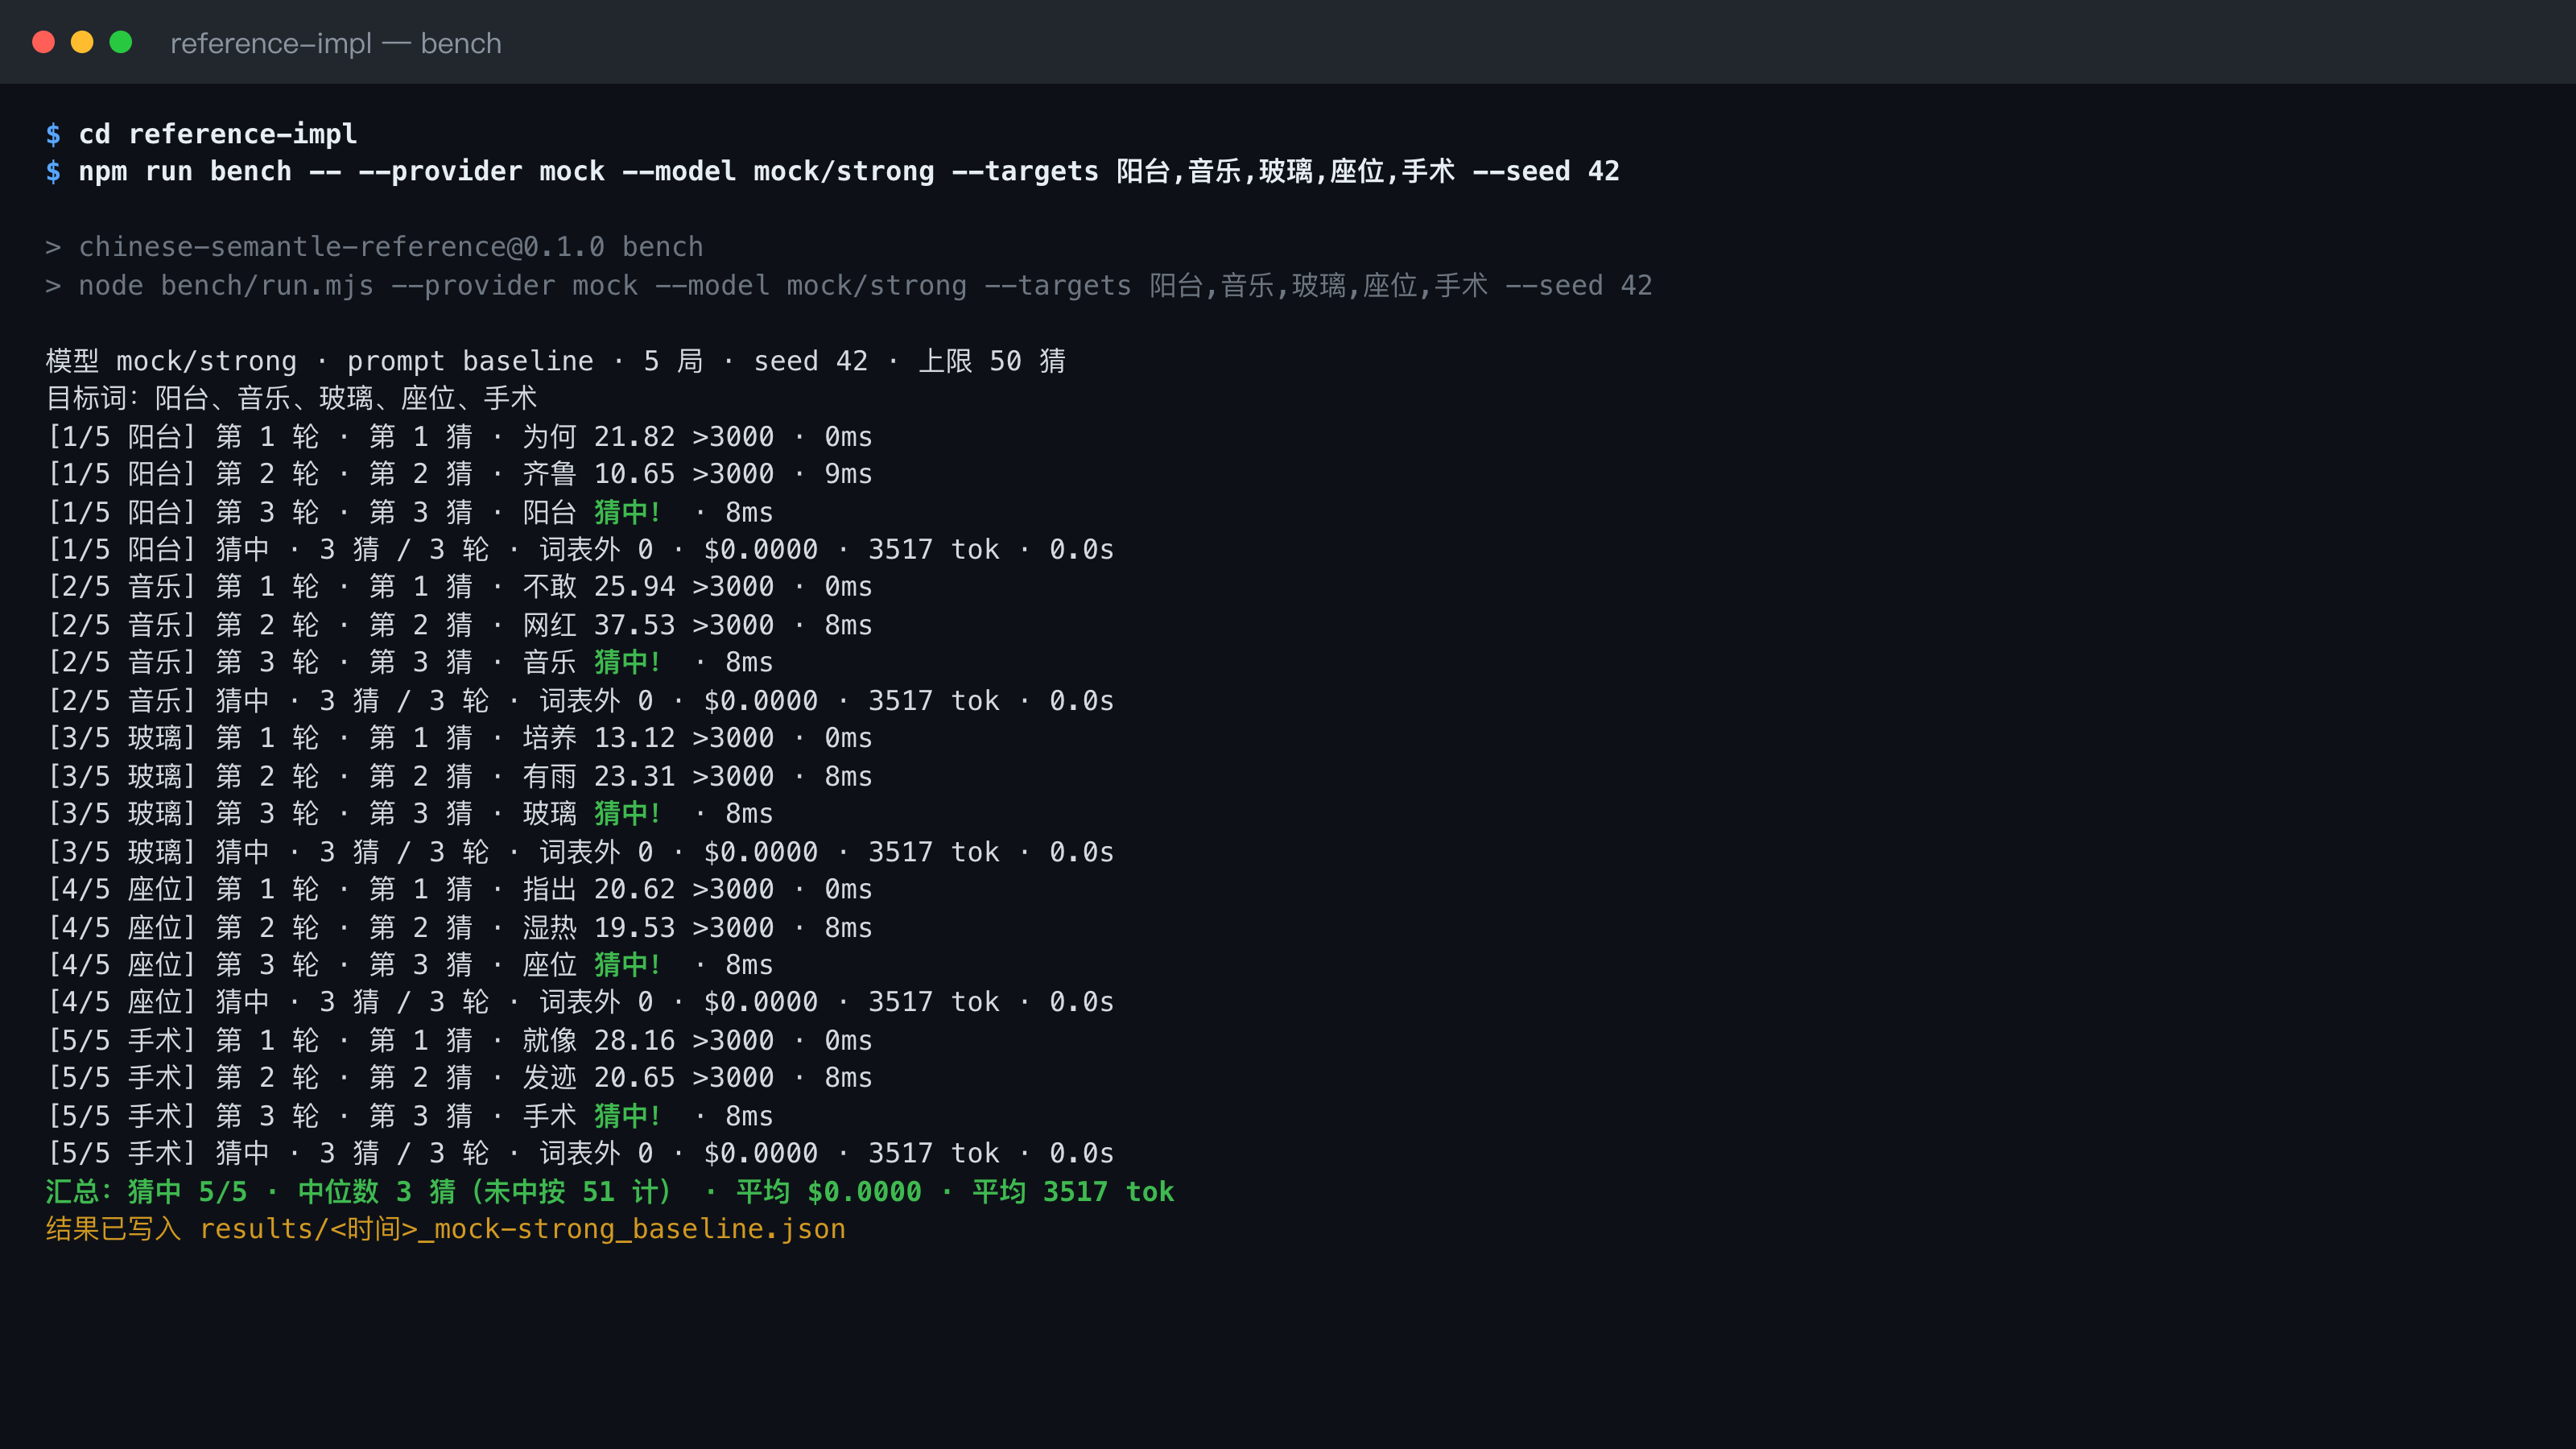
npm run bench --
--provider mock --model mock/strong
--targets 阳台,音乐,玻璃,座位,手术
--seed 42
它是一个不联网的假模型:只拿「猜过的词 + 分数」和词向量做三角定位,从不接触目标词。所以每轮 8 毫秒、花费 $0.0000、三猜就中。真模型一轮几十秒,也没有这么直。
打开你刚跑那一局,对着我说一遍:第 3 轮的词,是从前两轮哪两个分数推出来的?讲得出来,你就看懂这个循环了;讲不出来,多半是你的 prompt 没告诉它分数是什么意思。
让 agent 自动跑通 3 局,并读懂其中一个结果文件
- 先存档,再动手;检查 key 但不要泄露它:确认 .env 里有 OPENROUTER_API_KEY,确认 .gitignore 里有 .env 这一行。永远不要把 key 贴进对话、截图,也不要发给任何人。
- 给你的 prompt 起名:prompts/<你的名字>-v1.md。文件名去掉 .md 就是 promptId,会写进每个结果文件。第 6 节要冻结这个版本 —— 从今天起它叫 prompt A。
- 跑 3 局,每局填一行记录表:局 / 模型 / 目标词 / 轮数 / 猜中?/ 花费 / 翻车备注。先用最便宜的对照组把流程跑通,再换旗舰。跑通 3 局就存档。
- 打开一个结果 JSON,指出这几样各在哪:model、promptId、games[].target、games[].history、games[].solved、games[].guesses、games[].usage.costUsd。
- 找一个翻车:重复猜同一个词、猜到词表外、一次输出好几个词导致解析失败、或者 50 轮没猜中。记下第几轮、原文是什么。
三个结果 JSON(带电脑来,或截两张图:results/ 目录一张、打开其中一个 JSON 一张);填好的记录表;你的 v1 prompt 原文。
完整版在 docs/homework/lesson-05.md,里面有记录表、自检清单和排障模板。卡住了按那份的「卡住了怎么办」走,前两步做完还不行再问我。
那份自检清单里最容易漏的一条:三局都要跑到结束状态(猜中,或者 50 轮用完),中途报错停掉的不算。
循环里最重要的
那一行,是你写的
那段话。
循环几十行,谁写都一样;prompt 只有你有 —— 今天这份就叫 prompt A。第 6 节:Eval,接满六个模型做出排行榜;课后你还要写一个风格完全不同的 prompt B。