模型内部
六个词,一页一个:token、context window、attention、pretraining、post-training、RL。讲完你亲手当一次传话筒,让网页版的 AI 来玩你的游戏,跑出这门课的第一份 benchmark 数据。
还是那堆小数,只是从一千万个变成两万四千亿个
50000 个词 × 200 维 × 4 字节 = 40 MB,就是你项目里的 data/vectors.f32。一个词就是 200 个小数,分数就是两串小数的点积。
这些数字是查出来的:写死在文件里,谁去查都一样,永远不变。
参考实现的 models.json 里,Qwen3.8 Max 那条备注写着「2.4T MoE」——两万四千亿个参数。同样是浮点数,比你那个文件多二十几万倍。
这些数字是算出来的:没人写过其中任何一个,它们是训练时被搜出来的。
今天这一节不教任何「加一句就变强」的写法,只教六个词。判断一条知识值不值得现在学,有个很简单的测试:它能不能解释好几种现象,能不能预测下一代模型怎么表现。「一步步想」这类咒语解释不了别的事,也预测不了明年;今天这六个词,每一个都过得了这个测试——而且待会儿你在活动里看到的每一个奇怪现象,都能用它们解释。
模型看到的不是字,是一串编号
模型读写文字的最小单位。你的话先被切成一段一段,每一段换成一个整数编号,然后才进入计算。中文大约一到两个字一个 token。
类比:超市收银台。收银员不认「你手里那盒牛奶」,只认条码上那串数字;扫完之后,牛奶在系统里就只是一个编号。
你要求四句诗的头一个字连起来是「新年快乐」。它看到的不是四个字,是几个编号——「新年」很可能整个是一个 token,它没法伸手进去把「新」单独拎出来放在句首。
同一类的还有:数一个汉字有几笔、数一段话里有几个逗号。上节课那个「strawberry 里有几个 r」,是这件事的英文版。凡是要求它看见 token 内部的活,都容易翻车。
token 是 context window 的计量单位——「它一次能看多少」,量的是 token 数,不是字数。
token 也是账单的单位。models.json 里所有价格都写成「每百万 token 多少美元」。你多贴一轮历史,就是多花一笔钱。
记住这一句就够了:模型不认字,只认编号;一切长度和一切价格,都按编号的个数算。下一页就是这把尺子量出来的第一个数。
它一次只能看见桌面那么大,挤下去的就再也看不见了
你写作业时摊在桌上的书本、草稿纸、手机,就是你此刻能同时看到的全部。桌子再大也有边;新东西一直往上堆,最早那张纸就被挤到地上——你不是忘了它,是它已经不在你视野里了。context window(上下文窗口)就是这张桌子,单位是 token。
Claude Sonnet 5 是 1,000,000 token,DeepSeek V4 Pro 是 1,048,576,而对照组 Qwen3.5-9B 只有 262,144——同一份历史,小模型的桌子只有旗舰的四分之一。
模型没有记忆。参考实现 bench/agent.mjs 每一轮都重发两条消息:system prompt,加上按分数降序排好的整张历史。所以 docs/models.md 的花费估算里,每猜一轮按 1500 个 prompt token 计——历史每轮重发一遍,越猜越贵。
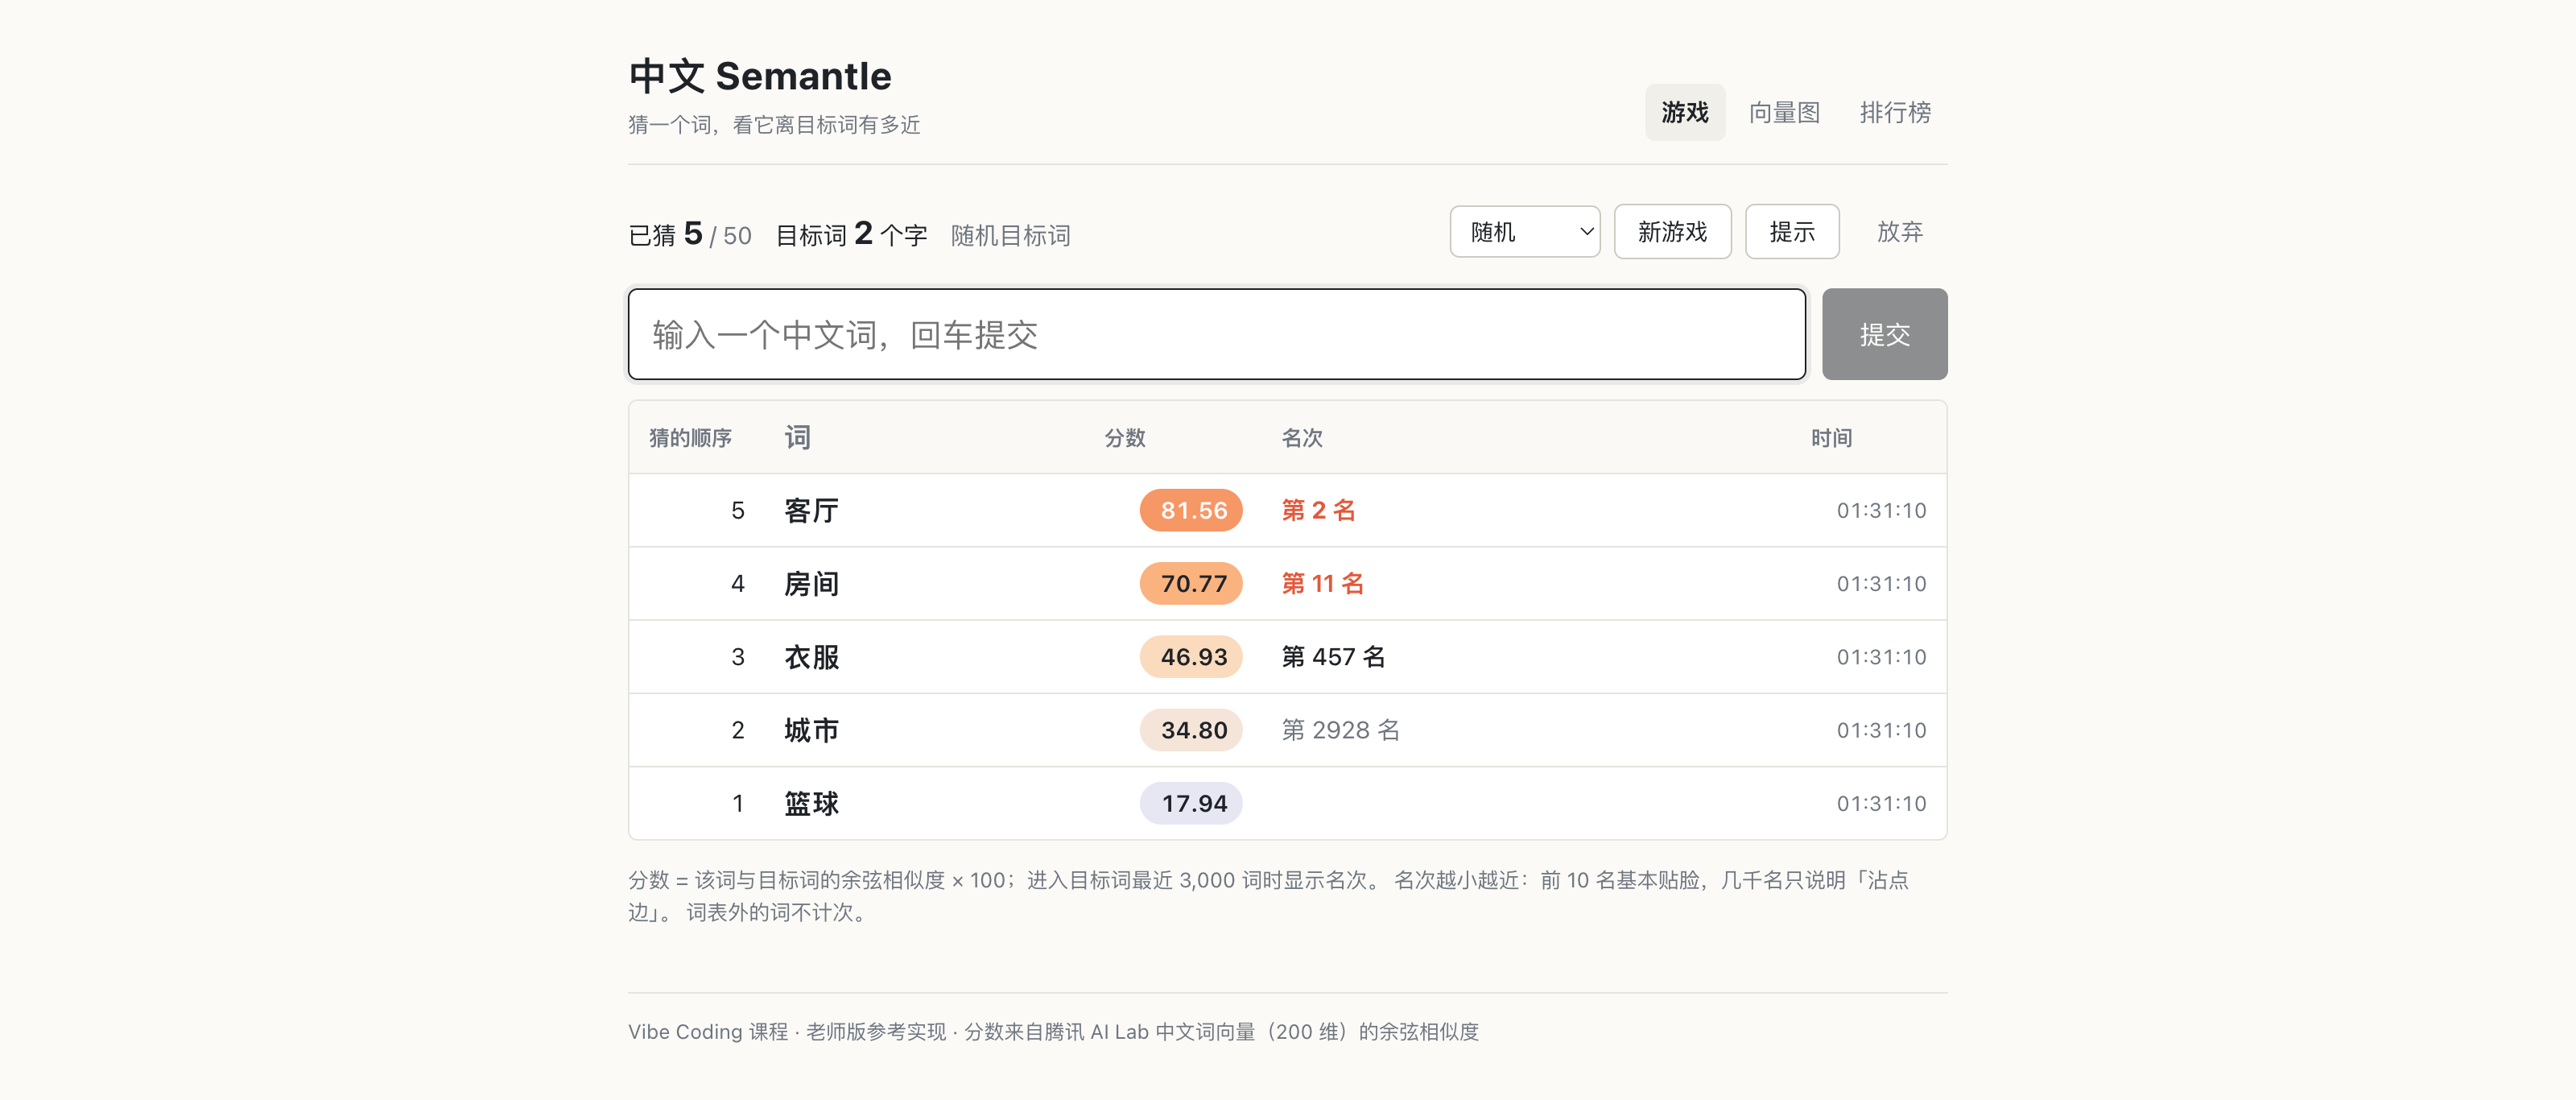
这是第 3 节那局(目标词是「阳台」)猜了五个词的样子。第 6 猜时,上面这五行会连同规则一起,重新变成 token 放进模型的桌面。
长对话为什么会忘掉开头;以及待会儿活动里,模型为什么会重复猜一个二十轮前就猜过的词。
attention 就是前文给后文加权——所以人设只改语气
「他把书放在桌上,然后它掉了。」——你读到「它」的时候,眼睛会不自觉往回扫,才知道掉的是书不是桌子。模型算每一个新 token 时做的就是这件事:给前面每一个 token 打一个权重,权重高的那些更多地决定这一步的输出。attention(注意力)不是玄学,就是一张「回头看谁、看多重」的权重表。
推论一:所以角色扮演只改语气。前文能决定它「在当哪个作者」,却加不了新能力——能力全在权重里,前文只能选择从哪片分布里采样。第 1 节那句「换的是语气,不是智商」,原因就在这。
推论二:所以把约束写清楚永远有用。你写下的每一条具体要求,都会真的进到那张权重表里,给后面每一个 token 加权。「顶级专家」四个字加权的是语气;「词表外的词返回「词表里没有这个词」」加权的是行为。
你贴回去的每一行「词 + 分数」,都是加权的材料。所以只回数字、不给提示,它才是在自己推理。
pretraining:把整个互联网读一遍,而且只读那一遍
想象一个人在考试前把图书馆里所有的书都背了一遍,练的只有一件事:给他任意半句话,他能接下一个词。背完就封卷,走进考场之后不许再翻书,也不许再背新书。
pretraining(预训练)就是这件事:在海量文本上反复练「猜下一个 token」,练出那两万多亿个参数。它极贵,而且只做一次。做完,权重就冻住了。
它问什么都答得上来,但答的是它读那一遍时的世界。之后发生的事,它不知道自己不知道。
你今天在对话里纠正它一百次,明天新开一个对话,它一个字都不记得——推理的时候权重是冻结的。它在这一轮里显得「学会了」,靠的全是桌面上那些 token,不是学习。
语料里有教授也有键盘侠,有论文也有帖子。它没有学成某一个人,而是把所有这些作者叠在一起——所以光靠预训练,它是一台谁都像的续写机。怎么把它变成一个助手,下一页。
post-training 是入职培训:它早就被训成助手了,你不用再给人设
预训练是「他把所有书都读完了」;入职培训是「教他在这家公司该怎么说话、什么不能做、被问到不懂的事要说不知道」。培训不给他新知识,只把他已有的本事收拢到一种得体的行为上。
post-training(后训练)就是这一步:拿人写的高质量对话做指令微调,再拿人的偏好把它对齐。做完之后,模型在没有任何人设的情况下,默认就是「一个尽力把事做对的助手」。
2020 年的模型没做过这一步,你不给人设,它就顺着你的话瞎续写,人设是最便宜的一个条件。现在这个条件已经被训练预先给好了,而且训练者用的数据比语料里随便哪类「专家」都强。你再套一个人设,等于在调好的分布上再加一层筛子——筛不出新能力,只筛出说话方式。
研究者做过对照实验:给模型套上各式各样的人设去答同一批事实题和推理题,准确率没有可靠提升,哪个人设更好几乎是随机的。第 1 节讲过一次,今天你知道了它背后的机制。
开局话术里一个人设都没有,只有规则和输出格式。两局都别改它——改了,两局就不可比。
RL 是刷题加批改——它学会了自己打草稿,所以那句咒语过期了
入职培训之后,还有一招:不再给他读新书,而是让他做题。做对了加分,做错了扣分,做一万遍,他自己会摸索出「先列条件、再一步步推、最后回头验算」这种更容易得分的做法。
RL(reinforcement learning,强化学习)就是这件事:给答案打分,让模型朝着高分的方向改。今天说的「推理模型」,靠的就是这一步。
2022 年有篇论文发现,在问题末尾加一句「Let's think step by step」,能让模型的算术正确率翻几倍。到 2024 年秋天推理模型出来,这句话就没必要了:模型答题之前自己会在你看不见的地方写几千字草稿,试错、回溯、纠正。今天教你的咒语,明年就是模型的默认行为。
草稿也是 token,而且按输出价计费。models.json 里 GPT-6 Astra、Gemini 3.1 Pro、Qwen3.8 Max 都是 reasoning 强制开启,Qwen3.8 Max 的默认档位甚至是 xhigh。所以参考实现跑 benchmark 时要加 --reasoning-effort low,否则六个模型跑一轮就能吃掉你充的 10 美元。
token · context window · attention · pretraining · post-training · RL。下一页看它们加在一起造成了什么后果。
训练方式不同,于是模型有强弱,也有几百倍的价格差
| 模型 | 定位 | context window | 输入 $/M | 输出 $/M |
|---|---|---|---|---|
| Claude Sonnet 5 | 旗舰 · 课上标准 | 1,000,000 | 2 | 10 |
| GPT-6 Astra | 旗舰 · 最贵的一个 | 1,050,000 | 10 | 50 |
| DeepSeek V4 Pro 0813 | 旗舰 · 开源权重 | 1,048,576 | 1.12 | 3.36 |
| Qwen3.5-9B | 对照组 · 9B 小模型 | 262,144 | 0.1 | 0.15 |
GPT-6 Astra 的 $50 对 Qwen3.5-9B 的 $0.15。就算只比三个旗舰,最贵的也是最便宜的十几倍。
这里一个数字都没说明谁猜词猜得快。贵不等于强,便宜也不等于弱——那个数字不在任何厂商的宣传页上,只能自己跑出来。今天你先用手跑两个模型,第 6 节让程序跑满六个。
docs/models.md 估过:六个模型各跑 3 局上限约 4.49 美元,其中 GPT-6 Astra 一家就占六成。
人肉 benchmark:你当传话筒
- 在自己的项目里 npm run dev,浏览器打开 http://localhost:5173,开一局新游戏。你的项目要是还没跑起来,就用我这台参考实现开一局,活动照做。
- 另开一个标签页,打开 ChatGPT / Claude / Gemini / DeepSeek 任意一家的网页版,新建一个空白对话。
- 把下面这段开局话术粘贴进去。只把两处 __ 填成游戏顶上写的那个数(「目标词 N 个字」,一开局就公开),其余一个字都不要改。
- 模型给一个词 → 你输进游戏 → 把分数(有名次带上名次)原样贴回对话框。只回数字,不夸奖、不提示。
- 每一轮记进 docs/benchmark-sheet.md 的表 A:第 N 猜 / 词 / 分数 / 名次 / 记号。
- 十三分钟内至少换一个模型再跑一局:新的网页、新的空白对话、同一段话术。跑不完没关系,记到第几轮算第几轮。
我们来玩一个中文猜词游戏。我心里有一个常见的中文名词,正好 __ 个字。
你每次只猜一个 __ 个字的词,我会告诉你它和目标词的相似度分数(0 到 100,
越高越接近,100 就是猜中)。如果这个词不在词表里,我会说「词表里没有这个词」,
这也算你猜了一次。每次回复只写一个词,不要解释。现在猜第一个词。
前三四轮它在撒网:食物、动物、地点各来一个,分数在 10 到 30 分之间。一旦某个词上了 40 分,它会开始围着那个词发散——换近义词、换上位词、换常一起出现的词,分数阶梯式往上爬。这就是 attention 在拿你贴回去的历史加权。
一次给好几个词、开始解释、反问你:回一句「只回一个词」,记号栏画「乱」,继续。
猜了猜过的词:回「猜过了,分数还是 X」,不计轮数,记号栏画「重」。
猜出词表外的词:回「词表里没有这个词」,这一轮要记。
游戏打不开:先查 reference-impl/README.md 的「常见报错」表(「连不上后端」「端口 3001 已经被占用了」两行),再不行就先用我这台参考实现,别在这一步卡住。
忍不住给提示:「往家具那边想」。这一局就作废了——你在帮它,不是在测它。只回数字。同理,别去点游戏里的「提示」按钮替它找词:那个按钮是给你自己玩的,人肉 benchmark 里按一下就等于替它作弊。
你刚才看到的三种表现,正好对应今天的三个词
拿到 40 分以上的词就不再撒网,改成围着它换近义词、上下位词,分数一级一级往上。
对应 attention。你贴回去的每一行都进了权重表;再加上 post-training 和 RL 教出来的「按规则办事」,它才会这么收敛。
十几轮过去还在换领域,分数在 10 到 30 分之间打转,从不围着最高分那个词做文章。
对应模型强弱。models.json 里那个 9B 对照组就是专门放进来演这一幕的:第 6 节的排行榜上,它多半垫底。
二三十轮之后,它重复猜一个第 8 轮就猜过的词,或者把已经报过的分数记错。
对应 context window。不是它笨,是历史越堆越长。把「第几轮开始重复」写进表 A,那就是你自己实测出来的一个数。
一条「第 23 轮起开始重复」的记录,比一局猜中更值钱:猜中只说明这次运气好,而这条记录能解释为什么。第 6 节做正式 benchmark 时,你要解释的就是这类现象。
再跑 2 局人肉 benchmark,交记录表
- 换两个模型各跑一局(至少一个是课上没用过的),每局在游戏里开新局、在模型网页版新建空白对话,开局话术一字不改。
- 逐轮填 docs/benchmark-sheet.md 的表 A;结束后填表尾:是否猜中、总轮数、观察。
- 观察栏写具体事实:第几轮开始重复、有没有一次输出多个词、有几个词表外的词。50 轮内没发生就写「50 轮内没发生」。
- 写一句对比,格式固定:「我觉得 <模型甲> 比 <模型乙> 强 / 弱,但因为 <原因>,我不确定。」「因为」后面至少写一个原因。
- 下节课前注册 openrouter.ai,充值约 10 美元,生成一把 sk-or- 开头的 key 存进密码管理器。key 不要贴进任何对话或截图。
填满的表 A 两份(纸或电子版);每局最后一轮的模型网页截图各一张,共 2 张;第 4 步那一句对比。
完整的传话协议、自检清单和排障顺序都在 docs/homework/lesson-04.md,照着走就行。
选看,不交:3Blue1Brown 的动画《大语言模型的简要解释》,8 分钟,把今天的参数、attention、pretraining、post-training 又过了一遍。B站官方双语版 BV1xmA2eMEFF;attention 那一页的展开版在作业单最后。
你今天
就是那个 agent。
读历史、想一个词、拿到分数、再想下一个——你刚才手动跑的那个循环,第 5 节我们把中间那个传话筒换成一段程序。带着填满的表 A 和你的 OpenRouter key 来。