词变成数字
今天上半节,你会在纸上算出一个分数;下半节,你的游戏开始算真分 —— 每个词都是 200 个小数,分数就是这两串数字的夹角。
那个分数不是老师定的,是两串数字算出来的
| 和「医生」比 | 分数 | 名次 | 为什么 |
|---|---|---|---|
| 护士 | 81.34 | 第 2 名 | 同一间屋子里的两个角色 |
| 医院 | 78.90 | 第 5 名 | 几乎不会分开出现 |
| 苹果 | 27.19 | 没有名次 | 只是都在中文里出现过 |
| 篮球 | 26.58 | 没有名次 | 同上,基本无关 |
为什么「医院」比「苹果」离「医生」更近?这个分数到底是谁算出来的?
上半节回答「谁算的」:一个你能在纸上做完的除法。下半节回答「为什么」:把这份数据接进你自己的游戏,分数从假的变成真的。
注意最右边一列:越像的两个词,不是因为「意思接近」,是因为它们在中文里总出现在同一批句子里。这句话第 8 页会兑现。
机器读不到「词」,它先把词换成编号
有很长一段时间,你问模型「strawberry 里有几个 r」,它会自信地回答 2(正确答案是 3)。不是它不会数数,是它压根没看见那十个字母:这个词进模型之前已经被切成几段,每段换成一个编号,字母在那一步就没了。
这些段叫 token(词元)—— 模型读写文字的最小单位。具体怎么切,每家模型不一样,第 4 节再展开:那一节你会看到它同时是长度单位和计价单位。
| 词 | 在 vocab.json 里的下标 |
|---|---|
| 医院 | 700 |
| 医生 | 737 |
| 苹果 | 1260 |
| 香蕉 | 6446 |
data/vocab.json 是一个 50000 条的字符串数组,下标就是行号。我们这份中文表按「词」切,「苹果」整个是一条,不是「苹」加「果」。
编号本身没有任何意思:1260 不比 1259「大」,也不比 6446「像」。它只回答「是哪个词」,回答不了「有多像」。要算有多像,得给每个词再配一串数 —— 下一页。
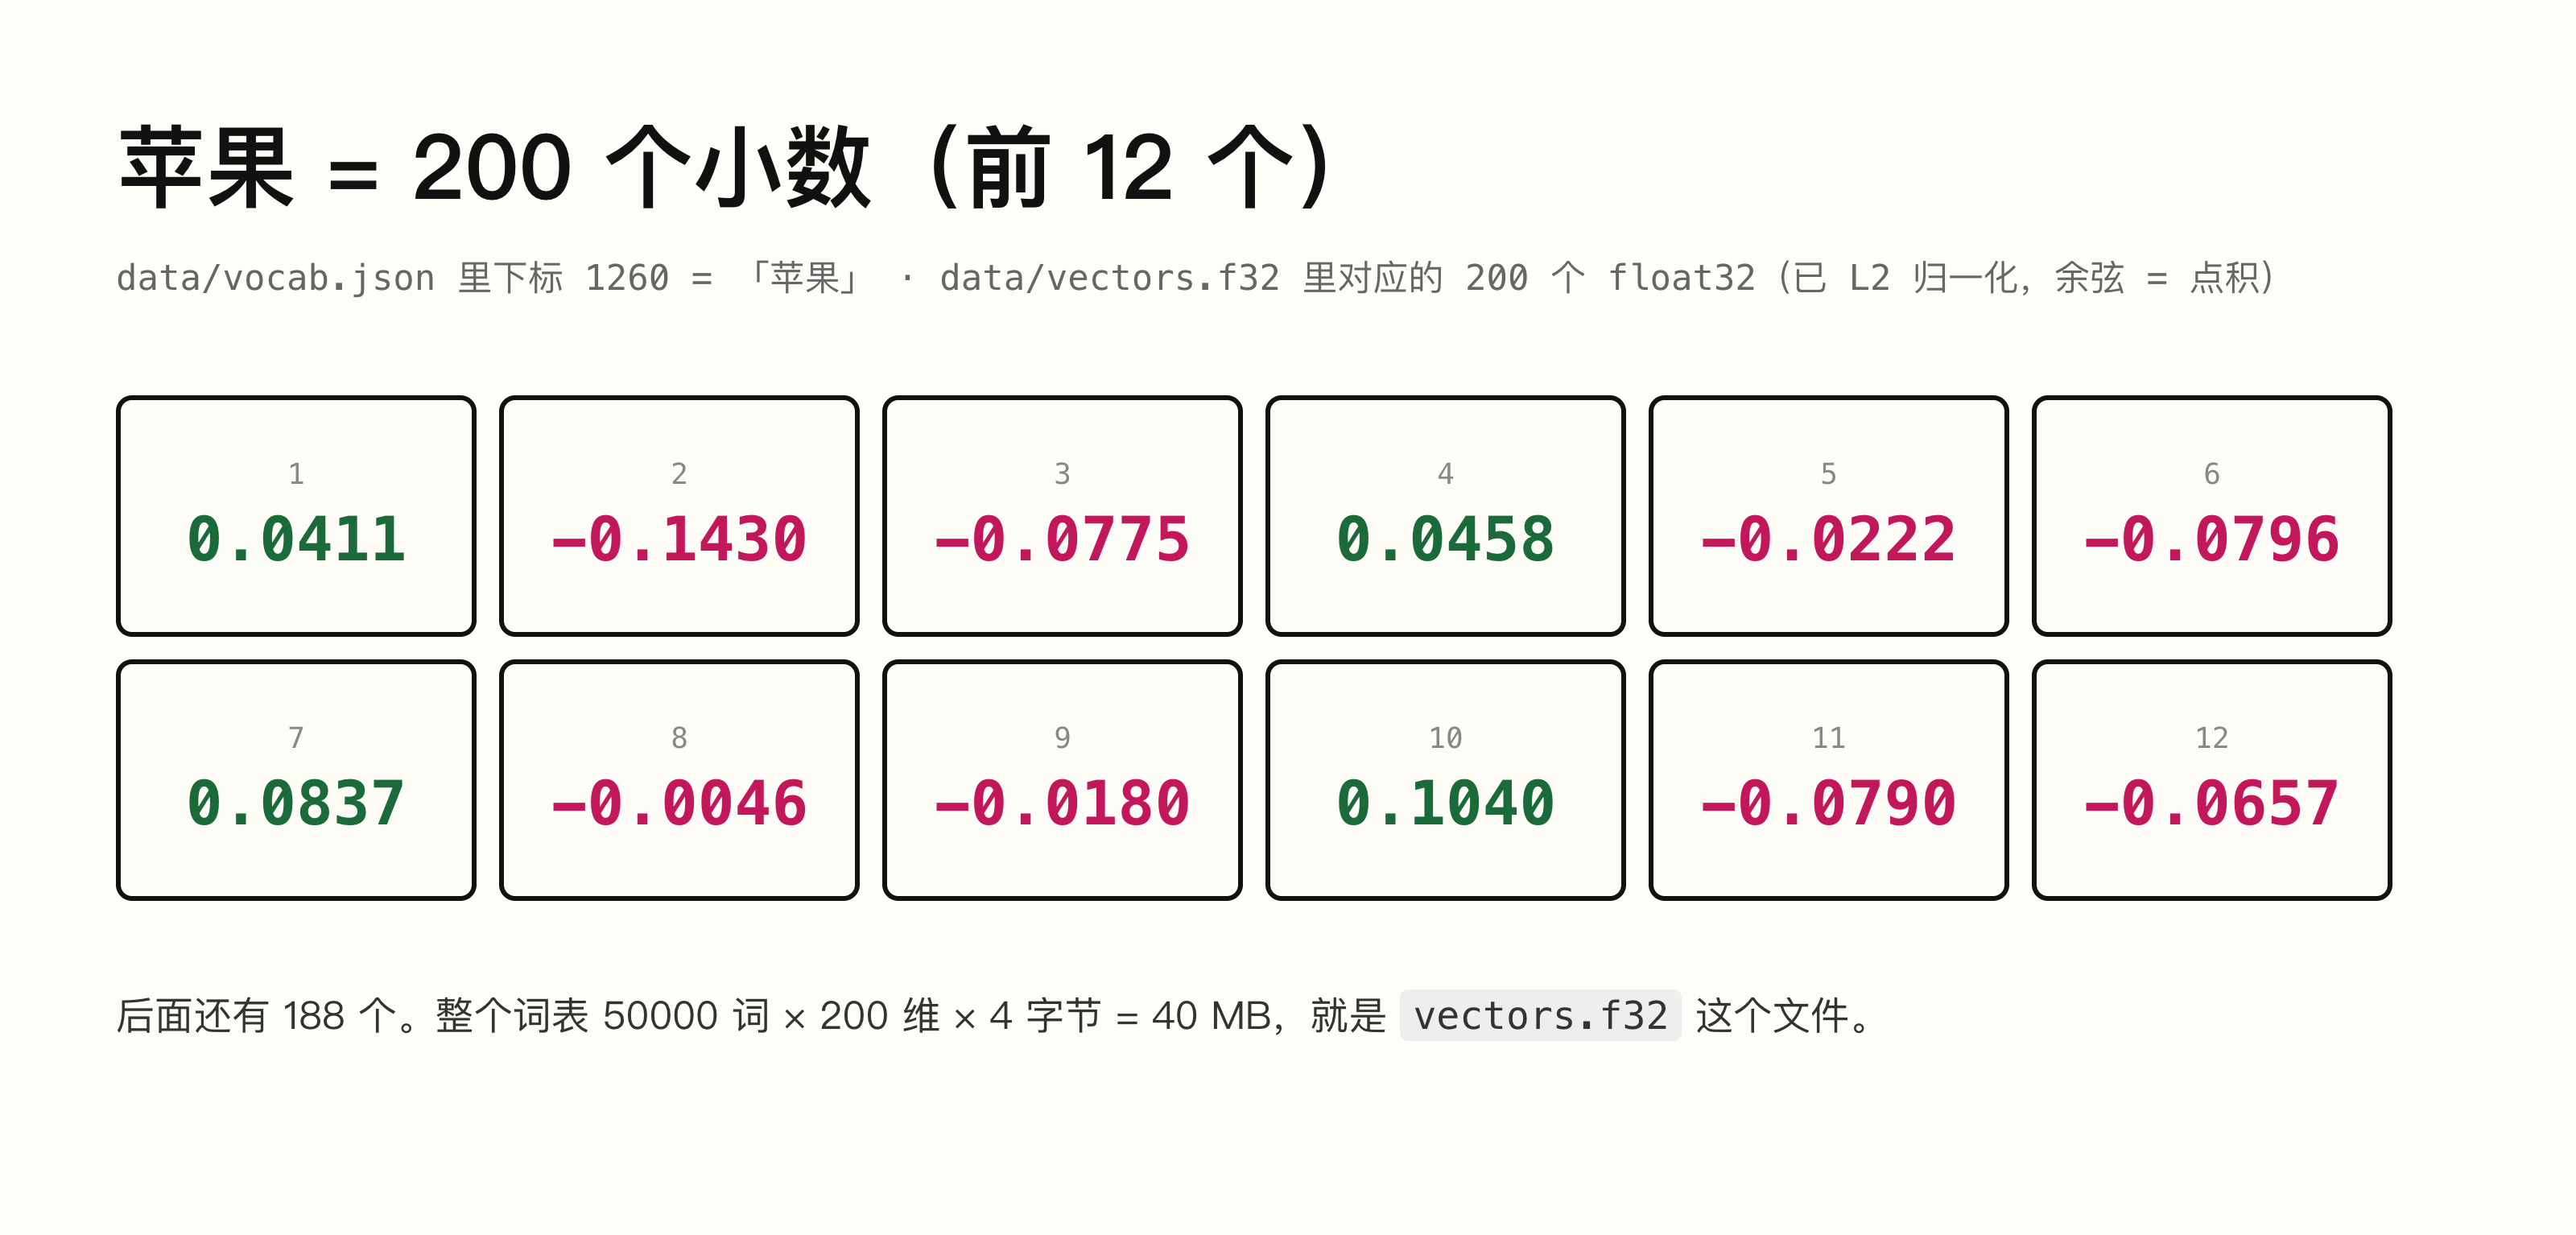
一个词 = 200 个小数,它们就躺在你项目的 data/ 里
这 12 个数是从 data/vectors.f32 里直接读出来的,「苹果」那一行的开头。后面还有 188 个。
「一个词一行,一行 200 个数」这句话,就写在 data/meta.json 里:"dim": 200、"count": 50000。你可以自己打开核对。
每个词都填了同一份 200 题的性格问卷,只是答案不是选项,是小数。两个词答案越接近,用法就越接近。
把所有词摆进同一个空间,同类的自己会挤在一起
医生 ↔ 医院 78.90 苹果 ↔ 香蕉 61.02 苹果 ↔ 医院 25.89。两片之间的空白,就是那个 25.89。
真实的空间有 200 个维度,屏幕只能画 2 个。这四个点的位置是我摆的,只为了让你看见「同类挤一起」。把真向量压成 2 维是第 7 节的 PCA,压完会失真。
不量两点之间的直线距离,量的是两支箭的夹角。为什么是夹角,下一页当场算给你看。
分数就是夹角:两支手电筒照的方向有多一致
医生 · 医院 = 6×8 + 8×6 = 96
|医生| = √(36+64) = 10 |医院| = √(64+36) = 10
cos = 96 / 100 = 0.96 → 游戏里显示 96 分
医生 · 苹果 = 48 − 48 = 0 → cos = 0,垂直就是无关
手算完这两组,你就不会再觉得分数是魔法
- 拿出纸和笔,两组你都自己算一遍:先做完组一,再做组二,过程分开写,别在脑子里跳步。
- 组一:P = (3, 4),Q = (6, 8)。按公式三步走:先点积,再算两个长度,最后相除。
- 组二:R = (5, 12),S = (12, -5)。同样三步,答案写成两位小数。
- 五分钟到,你把两个答案连过程一起讲给我听 —— 不光报数,还要说第二步是怎么算的。提前算完就做加分题:T = (1, 3),U = (-2, -6)。
cos(A, B) = (A · B) / (|A| × |B|) 分数 = cos × 100
写在纸上,别开计算器 —— 组一和组二开根号出来都是整数;加分题那组不是整数,但两个根号乘起来是。
两组都能在三步之内算完,答案写成两位小数,一定落在 −1.00 到 1.00 之间。其中一组会算出一个「太整齐」的数,整齐到你会「咦」一下 —— 那个「咦」就是这一页的全部意义,五分钟到我们一起说破。
卡在开根号上就先别开:把 |P| × |Q| 写成 √25 × √100,两个根号乘起来是 √2500 = 50。还卡就直接喊我,我把三步重新写一遍给你看 —— 这五分钟是后面 25 分钟的地基。
不要替他算,也别盯着笔尖看。等他写完第一步再瞄一眼有没有把点积和长度搞混 —— 那是最常见的一处,先纠这个。
总一起出现的词,被一次次推到一起 —— 这就是训练
每个词先拿 200 个随机小数,此时谁跟谁都不像,全是噪音。
从语料里拿一句话,遮住中间那个词,让程序凭左右的词猜它是什么。
猜错了,就把这个词的 200 个数往正确答案的方向挪一丁点。挪完换下一句。
常出现在相似句子里的词,被反复推向同一边,数字就变得相似了。这套做法叫 word2vec。
腾讯 AI Lab 中文词向量轻量版:200 维、143,613 个词、按词频从高到低排。老师跑一次 npm run prepare-vectors 把它转成 data/vocab.json 和 data/vectors.f32。
词表按词频取前 50000 个 1–4 字的纯汉字词,单字要在常用字名单里才收 ——「猫」「狗」「书」都能猜,生僻单字和纯虚词(「的」「了」)不收。
它学的是用法,不是词典释义。所以在这份语料里,「苹果」最近的三个词是 苹果公司 85.15、小米 75.17、三星 73.03 —— 它更像一家公司,不是一种水果。这不是 bug,是数据说的话。
真分数是后端算的,前端只负责把词送过去
前端
localhost:5173 client/同时跑着的另一个程序
localhost:3001 server/两个程序会互相说话
请求:我猜「苹果」
响应:{ score: 分数, rank: 名次 }
node_modules/ · 零件(npm install 拿回来的)第 5 节这里
会多一个框
程序之间敲门说话的固定格式:
一方发请求(request),一方回响应(response)。
按约定的格式问、按约定的格式答。
你自己也做了一个:后端那扇门。
谁在门后等着回答,谁就是服务器。
今天你的笔记本两个角色都当。
上节课这条线上传的是随机数,今天开始传真的分数;线没变,变的是后厨。
让 agent 把真词向量接进你的游戏
- 先存档,再动手:对它说「先存档,再动手」,让它在接线前拍一张照片。
- 解压老师发的 data 包,四个文件放进项目的 data/:vocab.json、vectors.f32、targets.json、meta.json,一共约 41 MB。
- 把右边那段 briefing 原样发给 Claude Code。三件事一件都不能少:词表在哪、每个词 200 个 float32、分数 = 余弦 × 100。最后两条是跟试玩页对齐的规则。
- 它改完后跑 npm run dev,开一局新游戏,依次猜「苹果」「香蕉」「政府」。
- 让它把三个已知的数算给你看:苹果–香蕉 61.02、苹果–政府 34.19、医生–医院 78.90。三个都对上才算接通。下一页五组数全对上就存档,说明写「接上真分数」。
<goal> 把 data/ 里的真词向量接进游戏,分数改成真的。 </goal> <constraints> - 词表 data/vocab.json,下标 = 行号 - 向量 data/vectors.f32,每词 200 个 float32 - 分数 = 余弦相似度 × 100,后端算 - 词表外的词回「词表里没有这个词」 - 开局显示目标词几个字;提示不计次但进历史表 </constraints> <fallback> 格式和我说的不一样就先停下来问我,不要自己编。 </fallback>
同一局里同一个词永远是同一个分数,历史列表按分数从高到低排好,色块从暖到冷有明显梯度。下一页那张截图就是接通之后真实的样子。
先要证据,再让它改代码:把报错原文整段贴回去,要它先证明两个文件存在、大小对得上,再证明服务器启动时读到了。20 分钟到就停手,没接通的把最后一条报错抄下来。
它算得对吗:五组已知词,对不上就是没接通
| 一对词 | 应该得到 | 说明 |
|---|---|---|
| 苹果 ↔ 香蕉 | 61.02 | 同类,明显高 |
| 苹果 ↔ 政府 | 34.19 | 换了领域,掉下来 |
| 医生 ↔ 医院 | 78.90 | 同一个场景,很高 |
| 医生 ↔ 篮球 | 26.58 | 基本无关 |
| 苹果 ↔ 苹果 | 100.00 | 同一个词永远满分 |
系统先把目标词最近的 3000 个词排好队,你的词排第几就显示第几名;排不进这 3000 个就只有分数、没有名次。名次是「在这一局里有多接近」,分数是「客观有多像」。
有名次 ≠ 很近。3000 名只是 5 万词里的前 6%:前 10 名基本贴脸,前 100 名才叫很近,第 2928 名的「城市」只是沾到了边。
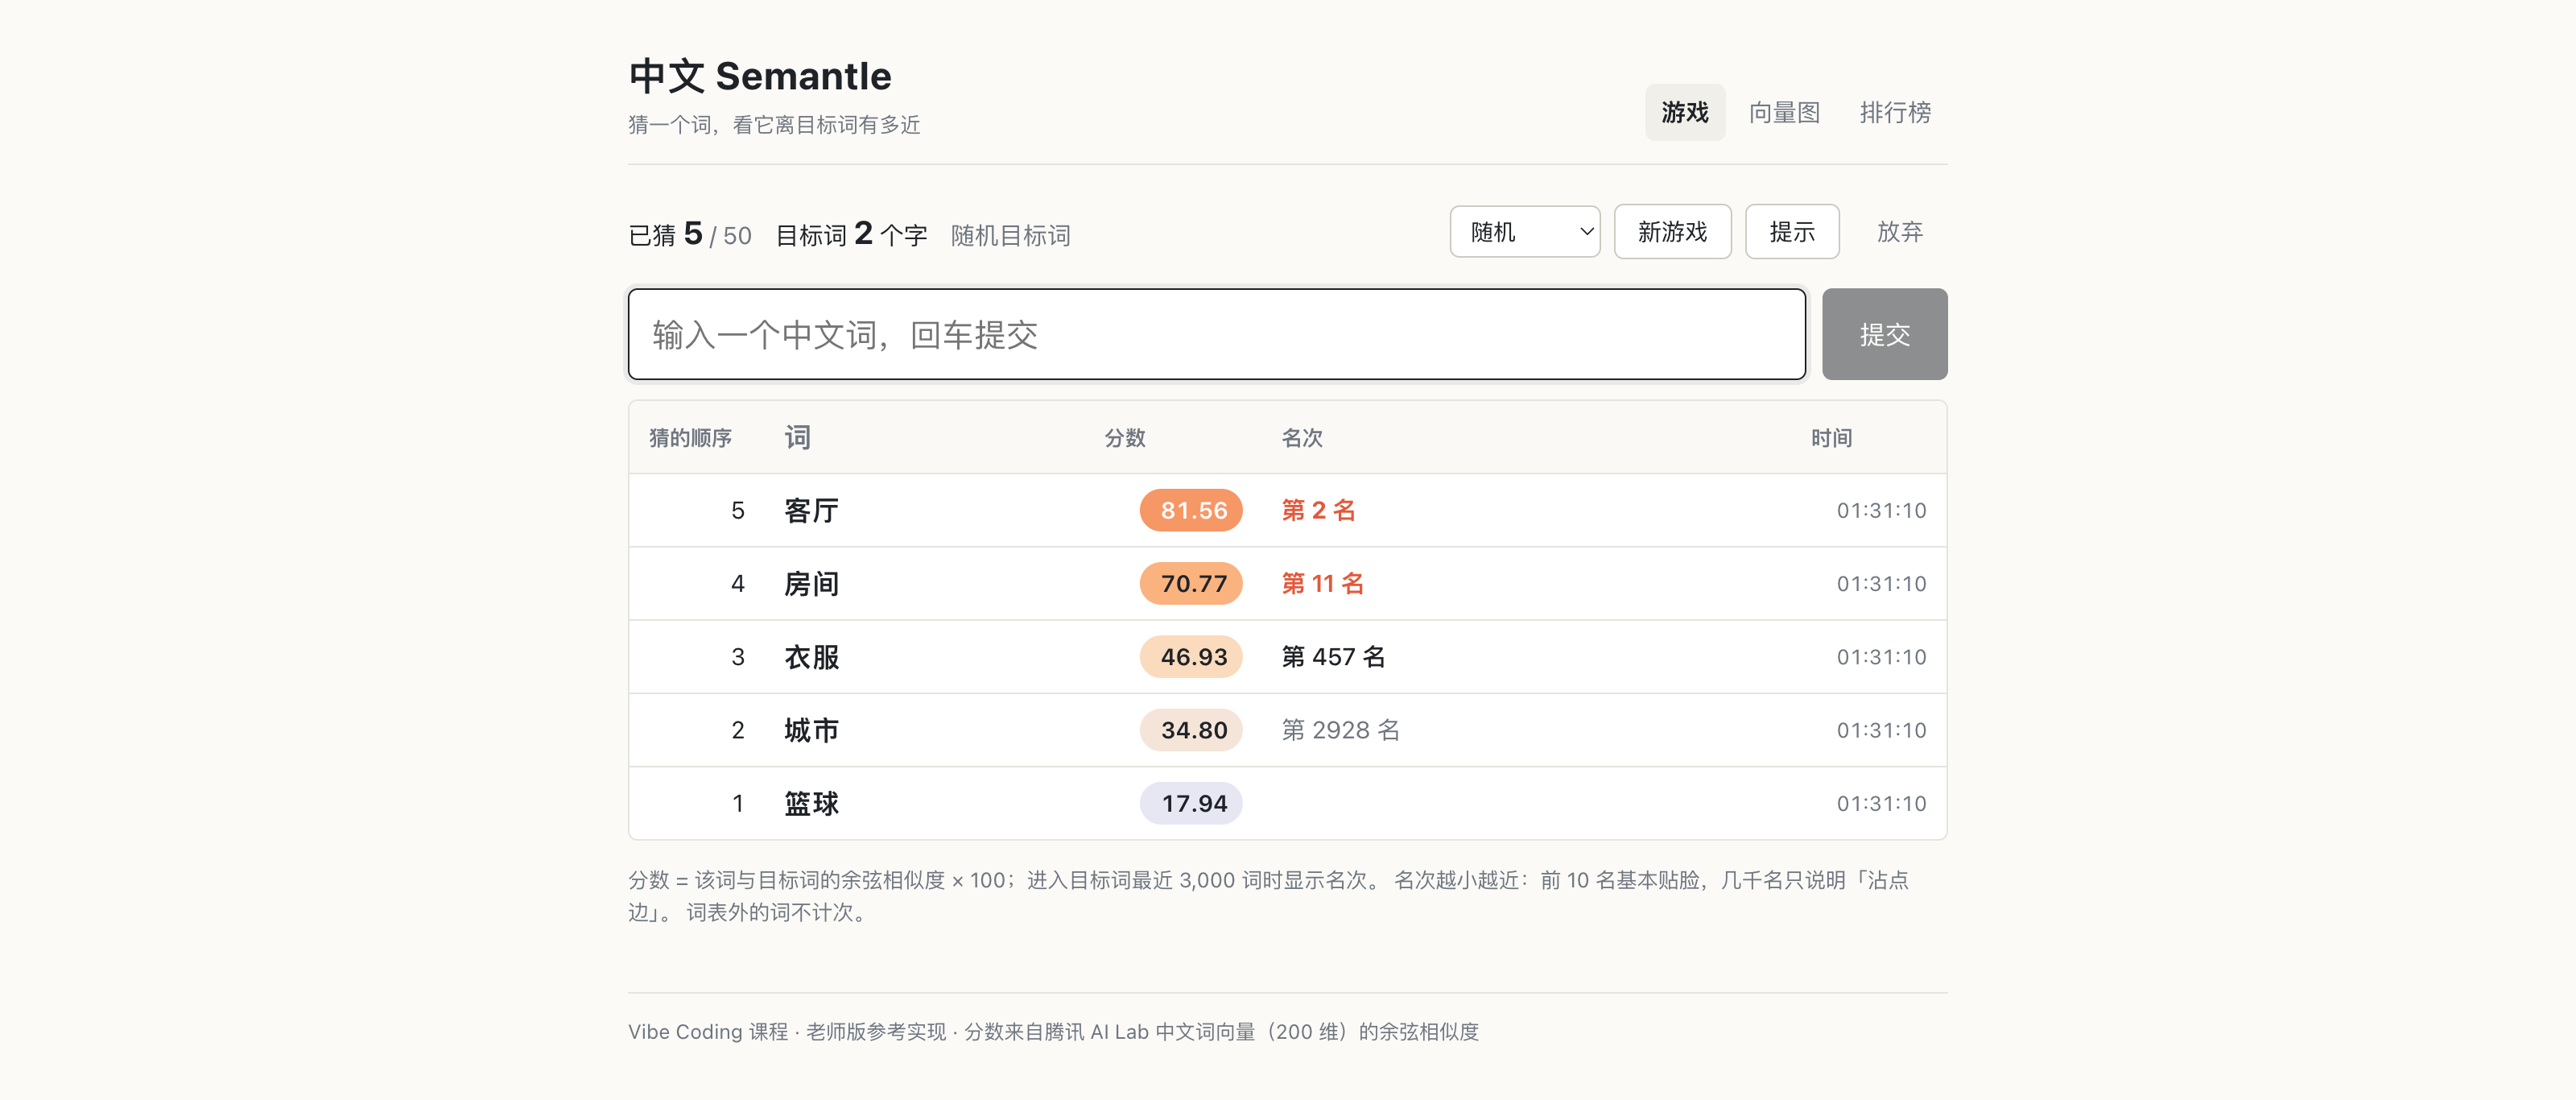
接通之后真实的样子:这一局目标词是「阳台」,五次猜测按分数从高到低排。客厅那一行的「第 2 名」就是名次;「城市」也有名次,第 2928 名,颜色却是灰的 —— 名次的字号和颜色按档位分层,一眼看得出「贴脸」还是「沾边」。顶栏那句「目标词 2 个字」一开局就在,是公开信息,不是点提示换来的。
自己玩 3 局,交一张记录表
- 先让它列出存档记录,确认「接上真分数」那一档在;再验证分数是真的:npm run dev 开一局,依次猜「猫」「狗」「桌子」。三个分数应各不相同,猫和狗该比猫和桌子更像;三个数一样就是没接通,跳到作业单的「卡住了怎么办」。
- 玩 3 局,每局玩到猜中或放弃(放弃会揭晓目标词)。第 3 局试个策略:先猜大类 —— 动物、食物、工具、地点、身体部位 —— 再往分数最高的那一类里细分。
- 每局填一行记录表:目标词、轮数、有没有猜中、分数最高的三个词、一个「没想到」。
- 试一次词表外的词(网络流行语或人名都行),确认你的轮数没有增加。
- 挑一个最让你意外的分数,写 1–2 句猜想。请用「它们常一起出现」来解释,不要用「意思相近」。
三样:填好的记录表(3 行);猜中那一局的截图 1 张,要能看到历史列表和分数;最后一步那 1–2 句解释。
完整步骤、记录表格式和自检清单在 docs/homework/lesson-03.md。加分题也在那里:猜一对你认为相反的词,看看分数是正是负。
意思,
是可以测量的。
第 4 节:模型内部 —— token、context window、attention、pretraining / post-training / RL,一页一个;然后用各家网页版做一次人肉 benchmark。